Dịch từ bài viết trên dev.to: Test Rocket: Rethinking the Test Pyramid for the AI Era
Từ Tháp Kiểm Thử đến Tên Lửa Kiểm Thử
Cứ sau vài năm, cộng đồng kỹ sư lại vẽ lại tháp kiểm thử và gán cho nó một cái tên mới: Test Pyramid, Testing Honeycomb rồi Testing Trophy. Mỗi mô hình ra đời khi kinh tế học phát triển phần mềm có sự biến đổi đủ lớn, khiến hình dạng cũ trở nên lỗi thời.
Sự bùng nổ của AI vừa làm điều đó một lần nữa. Lần này, mô hình kiểm thử không còn mang hình chóp mà trông giống một quả tên lửa hơn.
Tôi gọi đó là Test Rocket.
Hành trình từ Test Pyramid đến Testing Trophy
Mô hình Test Pyramid cổ điển đưa ra lời khuyên: viết thật nhiều unit test vì chúng nhanh và rẻ, bớt lại integration test, và chỉ giữ một lượng rất nhỏ E2E test. Triết lý này thống trị trong thời gian dài: unit test dễ viết, chạy nhanh; càng lên tầng cao hơn thì test càng chậm và tốn chi phí.
Test Pyramid
Cách tiếp cận trên hoạt động tốt cho đến khi ứng dụng ngày càng phình to. Khi hệ thống chuyển dịch thành một mạng lưới microservices tương tác với nhau, những bug nghiêm trọng nhất không còn nằm gọn trong một hàm đơn lẻ.
Bug thực sự sống ở khoảng trống giữa các thành phần — một lỗi sai lệch serialization ở đây, một giả định timeout sai lầm ở kia.
Spotify vấp phải bài toán này với hệ thống microservices và đề xuất mô hình Testing Honeycomb. Cốt lõi tư duy của họ rất rõ ràng: sự phức tạp thực sự của dịch vụ nằm ở cách nó giao tiếp với database và các service khác. Việc mock sạch mọi thứ trong unit test sẽ dẫn đến thảm họa: kiểm thử chi tiết triển khai (implementation details) thay vì kiểm thử hành vi thực tế. Vì vậy, họ dồn trọng tâm vào integration test và chủ động thu hẹp tầng unit test.
Kent C. Dodds cũng đưa ra quan điểm tương tự cho mảng frontend với mô hình Testing Trophy: static analysis làm nền móng, tầng unit test vừa phải, integration test gánh phần lớn khối lượng ở giữa, và một tầng E2E test mỏng nhẹ phía trên.
Testing Trophy
Điểm đắt giá nhất ở đây không phải là phủ nhận giá trị của unit test, mà là lời thách thức gửi đến một giả định cũ: cho rằng integration test luôn chậm và đắt đỏ. Công cụ hiện đại đã giúp integration test chạy đủ nhanh để dùng thoải mái, đồng thời bắt được nhiều bug thực tế hơn trên mỗi bài test nhờ khả năng vận hành đồng thời nhiều thành phần.
Cả Honeycomb và Trophy đều chung một luận điểm cốt lõi:
Một đống unit test cô lập sẽ trở thành khoản đầu tư tồi tệ khi hành vi bạn thực sự quan tâm chỉ xuất hiện lúc các thành phần tương tác với nhau.
AI tái định hình bài toán kinh tế học
Cả Pyramid, Honeycomb lẫn Trophy đều chưa từng tính đến một yếu tố vốn chưa hề tồn tại ở thời điểm chúng ra đời: unit test có thể đóng vai trò như một vòng phản hồi siêu tốc cho AI coding agent, chứ không đơn thuần là tấm lưới an toàn dành cho lập trình viên con người.
Chỉ cần quan sát cách một coding agent vận hành, quy luật sẽ hiện ra rõ ràng: agent sửa code, chạy một bộ unit test lớn, đọc log lỗi, rồi tự điều chỉnh. Chu trình đó lặp đi lặp lại liên tục.
Vòng Phản Hồi của Tác Nhân
Vòng lặp này thay đổi hoàn toàn mục đích của bộ unit test. Unit test không còn chỉ là công cụ để kỹ sư duy trì nhằm bắt regression về sau, mà đã trở thành một phần trong chu trình làm việc của chính agent — phản hồi tức thì từng giây xem thay đổi vừa tạo ra có đúng định hướng hay không.
Phương trình chi phí vì thế bị đảo lộn. Trước đây, viết và bảo trì thêm 100 unit test đồng nghĩa với 100 đơn vị công sức của con người: phải tự viết, tự review và duy trì cho test xanh. Bây giờ, agent có thể sinh ra các bài unit test chất lượng chỉ trong vài giây.
Câu hỏi cũ “Liệu chúng ta có đủ nguồn lực cho chừng này bài test không?” không còn đúng nữa. Câu hỏi quyết định hiện tại là: “Liệu bộ test này có thực sự giúp agent biết điều gì đúng về mặt hành vi hay không?”
Ra mắt mô hình Test Rocket
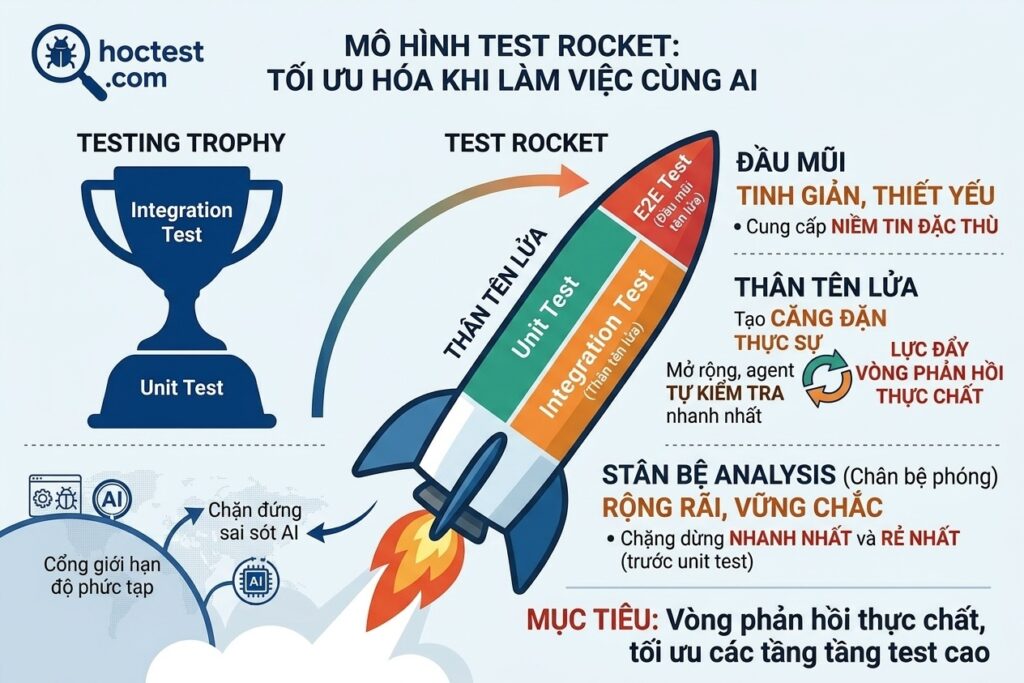
Mô hình Test Rocket vẫn giữ nguyên 4 tầng giống Testing Trophy (Static Analysis, Unit Test, Integration Test, E2E Test) nhưng phân bổ lại hoàn toàn tỷ trọng giữa các tầng.
Test Rocket
Tên gọi “Rocket” không chỉ mang tính trang trí:
- Static Analysis (Phân tích tĩnh) đóng vai trò làm chân bệ phóng: rộng rãi, vững chắc, thầm lặng giữ cho tên lửa không bị lệch quỹ đạo.
- Unit Test và Integration Test hợp thành thân tên lửa: hai tầng căng đặn thay vì một mỏng một dày như trước, bởi vì hiện tại cả hai đều tham gia tạo lực đẩy thực sự. Không tầng nào bị xem là thành phần phụ.
- E2E Test nằm ở vị trí đầu mũi tên lửa: nhỏ gọn, tinh giản nhưng vô cùng thiết yếu.
Mục tiêu của Test Rocket không nằm ở một con số tỷ lệ phần trăm cứng nhắc. Cốt lõi của nó là:
Xây dựng vòng phản hồi unit test và integration test thực chất, đồng thời giữ cho các tầng test cao hơn tập trung vào loại niềm tin mà chỉ riêng chúng mới có thể cung cấp.
Static analysis không đứng yên. Đây là chặng dừng nhanh nhất và rẻ nhất — nhanh hơn cả lần chạy unit test đầu tiên — nên trở thành nơi lý tưởng để chặn đứng các sai sót của agent trước khi chúng tiêu tốn một chu kỳ test đầy đủ. Các đội ngũ làm việc với AI agent đang khai thác tầng này ngày càng nhiều: siết chặt type checking, bổ sung custom lint rules cho các quy chuẩn nội bộ mà agent hay bỏ sót, tự động quét lỗ hổng bảo mật & thư viện phụ thuộc, đồng thời thiết lập cổng giới hạn độ phức tạp mã nguồn (complexity gates).
Unit test chính là nơi chứng kiến sự lột xác lớn nhất. Trong quy trình làm việc cùng AI, unit test là cách nhanh nhất để agent tự kiểm tra: “Liệu mình có vừa làm hỏng cái gì không?”. Điều này khiến việc mở rộng tầng unit test trở nên hoàn toàn xứng đáng, ngay cả khi các bài test hoàn toàn cô lập.
Tuy nhiên, “mở rộng” chỉ có ý nghĩa khi ta làm rõ nội dung bên trong. Thay vì hình dung đây là tầng unit test của Trophy được vặn max volume, hãy nhìn nó dưới góc độ những danh mục test hoàn toàn mới — những bài test vốn rất đáng giá nhưng trước đây hiếm khi tồn tại vì rào cản chi phí:
- Bài test ranh giới và trường hợp biên (Edge cases & boundaries): Kiểm thử giá trị null, collection rỗng, lỗi chênh lệch 1 đơn vị (off-by-one) — những kịch bản đúng về mặt nguyên tắc nhưng luôn bị bỏ qua khi con người phải tự tay viết từng dòng.
- Bài test dựa trên thuộc tính (Property-based testing): Kiểm tra các quy tắc bất biến (invariants) trên một tập đầu vào ngẫu nhiên được sinh tự động, thay vì chỉ dừng lại ở 2-3 ví dụ thủ công.
- Bài test hồi quy vĩnh viễn cho mỗi bug được sửa: Đảm bảo lỗi do agent khắc phục sẽ không bao giờ quay trở lại — điều mà mọi nhóm phát triển luôn muốn thực hiện nhưng hiếm khi duy trì được.
- Bài test đặc tính (Characterization testing): Ghim cố định hành vi hiện tại trước khi refactor, tạo ra tấm lưới an toàn cho agent và reviewer trước những thay đổi rủi ro.
- Bài test hành vi phạm vi hẹp (Narrow behavioral tests): Bao bọc chính xác vùng code agent đang thao tác, giúp khi có lỗi sẽ chỉ ra chính xác vị trí hỏng thay vì báo lỗi integration chung chung.
Không có loại test nào ở trên là lạ lẫm. Chúng đều là những bài test mà một kỹ sư cẩn trọng luôn muốn có nhưng hiếm khi đủ thời gian để hoàn thiện. Bản chất của một bài test tốt không thay đổi. Điều thay đổi duy nhất là: chi phí để tạo ra chúng giờ đây đã đủ rẻ để thực sự tồn tại.
Integration test vẫn đảm nhận nhiệm vụ mà unit test không thể thay thế: chứng minh database, HTTP boundary và message queue hoạt động trơn tru cùng nhau. AI cũng hỗ trợ tầng này bằng cách sinh nhanh fixture và test container. Tuy nhiên, việc dựng một dependency thực sự và chờ đợi I/O không thể giảm chi phí thời gian theo cách sinh code unit test được. Đó là lý do tầng này không cần một danh sách “những tính năng mới”: nó đã rất vững chắc từ thời Honeycomb và Trophy. Rocket không cắt giảm integration test để dồn tiền cho unit test — nó giữ cho cả hai cùng mạnh mẽ.
E2E test đứng ở đỉnh tháp, chốt chặn những hành trình người dùng quan trọng nhất. Việc AI tạo code giá rẻ không thay đổi được bản chất kinh tế của E2E test, bởi chi phí của tầng này không nằm ở khâu viết test, mà nằm ở khâu thực thi: một trình duyệt thật, một backend thật, thời gian tính bằng phút thay vì mili giây, cùng nguy cơ flaky test mà không công cụ AI nào sửa triệt để được. Agent có thể viết 50 kịch bản E2E dễ dàng như viết 5 kịch bản, nhưng chạy cả 50 kịch bản đó trên mỗi lần commit vẫn là một cơn ác mộng về tốc độ. E2E test vẫn đủ đắt đỏ để bạn không muốn gánh thêm phần việc mà unit test và integration test đã cover.
Nhưng chẳng phải unit test từng bị coi là mầm mống rắc rối sao?
Đây là một thắc mắc hoàn toàn chính đáng, và lời phê bình kinh điển ngày trước vẫn đúng nguyên giá trị:
Một bài unit test tồi thì mãi mãi là một bài unit test tồi.
Nếu bài test sa đà vào kiểm thử chi tiết triển khai (implementation details), mock vô tội vạ mọi thành phần liên quan, gãy đổ mỗi khi đổi tên biến, hoặc tồn tại chỉ để làm đẹp báo cáo code coverage — thì AI có sinh ra nó nhanh tới đâu cũng chẳng thể giúp nó tốt lên được.
Điều thay đổi ở đây là yếu tố kinh tế học, chứ không phải tiêu chuẩn đánh giá một bài test chất lượng. Trước kia, người ta e ngại tầng unit test phình to vì lý do chi phí thời gian của con người: việc viết và bảo trì một đống test cô lập không đem lại hiệu quả đầu tư bằng integration test — vốn mang lại niềm tin cao hơn trên mỗi dòng test. Nhưng khi chi phí biên (marginal cost) để tạo bài test giảm về cận 0, còn giá trị của vòng phản hồi tức thì tăng vọt, bài toán kinh tế đó đã thay đổi.
Vì vậy, Test Rocket không phải là mô hình Test Pyramid bình mới rượu cũ. Nó không kêu gọi đưa unit test lên làm bá chủ, cũng không áp đặt một tỷ lệ 50/50 khiên cưỡng.
Thông điệp của Test Rocket cụ thể hơn nhiều: cả unit test lẫn integration test đều không còn là những tầng mỏng nhẹ nữa. Honeycomb và Trophy từng buộc phải bóp nhỏ một trong hai tầng vì rào cản chi phí sản xuất. Khi rào cản đó bị gỡ bỏ, tỷ lệ phân bổ tối ưu sẽ do chính vị trí phát sinh bug thực tế quyết định, chứ không phải do chi phí viết test quy định.
Mỗi tầng test vẫn đảm nhận một sứ mệnh riêng biệt:
- Unit Test: Xác minh hành vi cục bộ cụ thể có bị phá vỡ hay không?
- Integration Test: Xác minh các thành phần thực tế có tương tác trơn tru với nhau không?
- E2E Test: Xác minh hành trình người dùng có hoạt động thông suốt từ đầu đến cuối không?
- Static Analysis: Xác minh mã nguồn có đạt tiêu chuẩn cấu trúc cơ bản không?
Một lưu ý quan trọng hơn vẻ ngoài của nó
Tới đây, tôi muốn nhìn lại và phản biện chính ý tưởng của mình, bởi mô hình này ẩn chứa một cái bẫy rất lớn mà không phải ai cũng nhận ra ngay.
Mối lo ngại bề nổi là vấn đề lãng phí: các đội ngũ sẽ sinh ra hàng loạt bài test giá trị thấp chỉ vì giờ đây việc đó quá rẻ. Nhưng mối lo sâu xa hơn chính là bài học từ thời Honeycomb: những bài unit test cồng kềnh, cô lập, bám chặt vào chi tiết triển khai sẽ trở thành lực cản khủng khiếp khi refactor code.
Test do AI tạo ra với giá rẻ sẽ khiến tình hình tồi tệ hơn trước khi nó có thể tốt lên. Agent luôn có xu hướng viết test soi chiếu đúng cấu trúc code hiện tại để được báo xanh thật nhanh.
Một bài test sinh ra trực tiếp từ code sẽ chỉ khẳng định: “Code đang chạy đúng những gì nó được viết” — điều này hoàn toàn vô giá trị trong việc chứng minh tính đúng đắn của phần mềm.
Việc bắt mọi bài test phải qua con người review không giải quyết được gốc rễ bài toán. Nó chỉ dời nút cổ chai sang chỗ khác và bẻ gãy tốc độ phát triển. Giải pháp bắt buộc phải tự động hóa:
- Tạo test từ spec thay vì từ code: Sinh test trực tiếp từ yêu cầu tính năng (spec) mà không cho AI nhìn thấy phần triển khai code, giúp test không bị dính chặt vào implementation.
- Tạo test từ kế hoạch agent cam kết trước khi gõ code: Tạo ra một lớp kiểm chứng độc lập và bổ sung thêm một tín hiệu xác nhận đáng giá.
- Áp dụng TDD (Test-Driven Development): Khi bài test bắt buộc phải sẵn sàng trước khi triển khai code, nó sẽ không thể bị bóp méo để chạy theo một đoạn code chưa hề tồn tại.
- Dùng một agent đối kháng thứ hai: Sử dụng agent độc lập để truy quét sự lệch pha giữa bài test và hành vi thực tế, thay vì tin tưởng mù quáng vào context triển khai.
- Chạy Mutation Testing định kỳ: Xóa bỏ các test rác bằng cách chủ động bơm lỗi giả lập vào mã nguồn để kiểm tra xem bộ test có thực sự thất bại báo lỗi hay không.
Khâu review của con người vẫn cần thiết để đối soát spec, nhưng không được phép trở thành cổng gác chính. Cổng kiểm soát bắt buộc phải vận hành với tốc độ tương đương với agent mà nó giám sát.
Tóm lược ý tưởng cốt lõi
- Test Pyramid tối ưu hóa cho chi phí.
- Testing Honeycomb & Testing Trophy tối ưu hóa cho niềm tin và khả năng bắt lỗi tại các ranh giới.
- Test Rocket bổ sung mục tiêu thứ ba: tối ưu hóa cho tốc độ vòng lặp phản hồi của AI khi tạo và sửa code.
Sự chuyển dịch này nâng tầm giá trị của các tầng test tốc độ cao:
- Static Analysis trở thành chặng gác cửa đầu tiên cực kỳ hiệu quả giúp loại bỏ lỗi cấu trúc với chi phí tối thiểu.
- Unit Test cung cấp phản hồi hành vi siêu tốc cho agent.
- Integration Test & E2E Test chốt giữ mục tiêu xác minh độ tin cậy và niềm tin ở cấp độ hệ thống.
Unit test không trở thành một ý tưởng đột phá hơn. Cái thay đổi hoàn toàn ở đây chính là mục đích sử dụng và chi phí tạo ra chúng.
Viết thật nhiều bài test không phải là đích đến cuối cùng. Mục tiêu tối thượng là xây dựng một hệ thống phân lớp phản hồi siêu tốc — cung cấp đủ tín hiệu để AI tự tin tăng tốc, đồng thời mang lại sự tự tin cho đội ngũ kỹ sư khi liên tục nâng cấp hệ thống.
Đó chính là Test Rocket 🚀.